以前の記事で、AMD Radeon PRO W6800(32GB VRAM)を使ってローカルLLM環境を構築しました。
同じPCでローカルLLM実行環境「Strata」を稼働させるため、メインメモリを32GBから64GBへ増強しました。
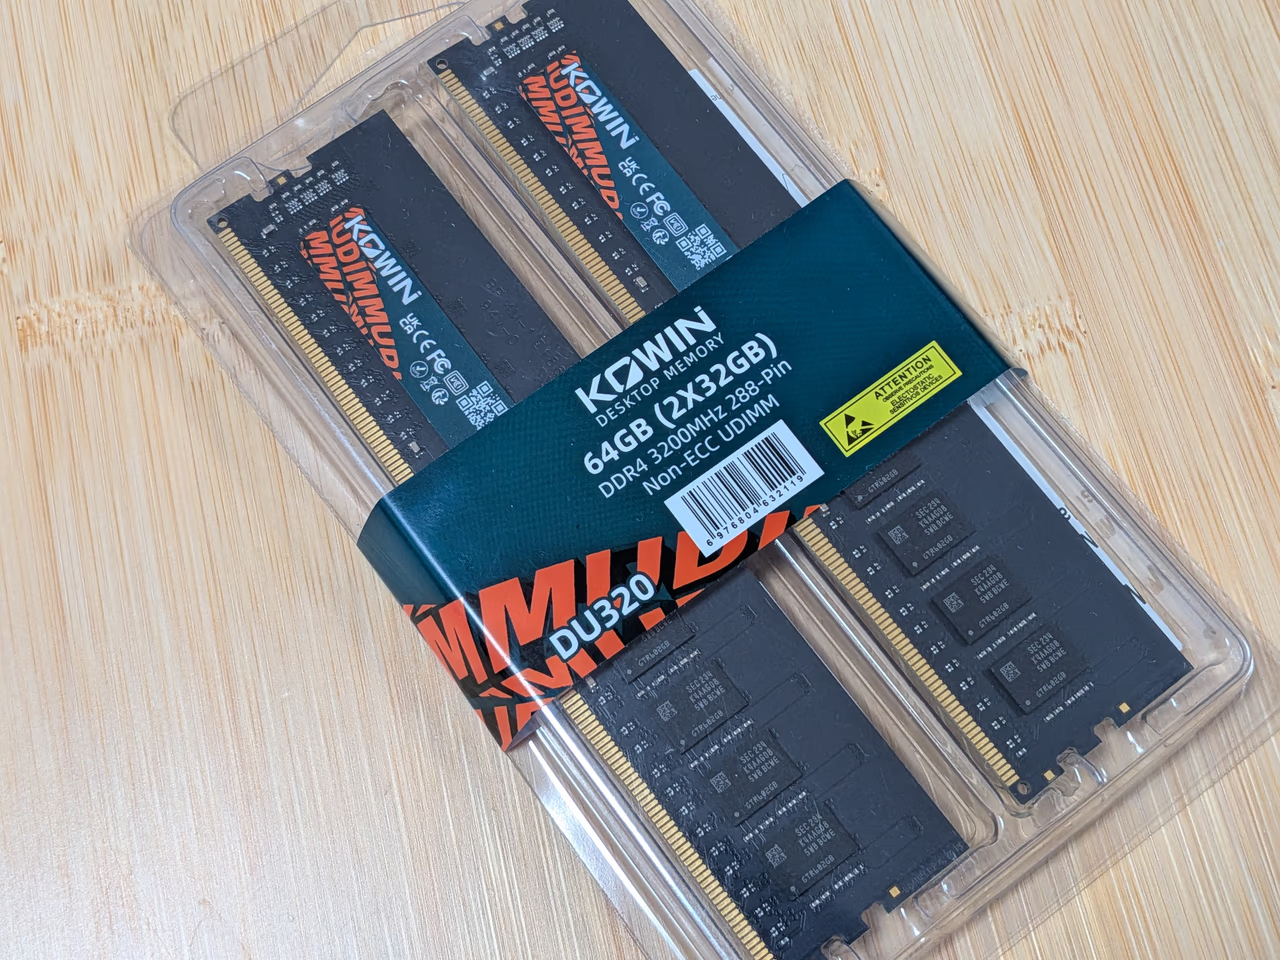
既存のメモリは16GB×2枚で合計32GB、DIMMスロットに空きがなかったため、KOWIN DU3200 UDIMM 64GB(32GB×2) DDR4-3200を導入しました。
用意したもの
KOWIN DU3200 UDIMM 64GB(32GB×2) DDR4-3200
KOWIN DU3200 UDIMM 64GB(32GB×2) DDR4-3200は、パソコン工房で扱っているDDR4メモリのセットです。 32GBモジュールが2本セットになっており、セール期間で安くなっていたので選びました。
メモリ交換手順
交換前
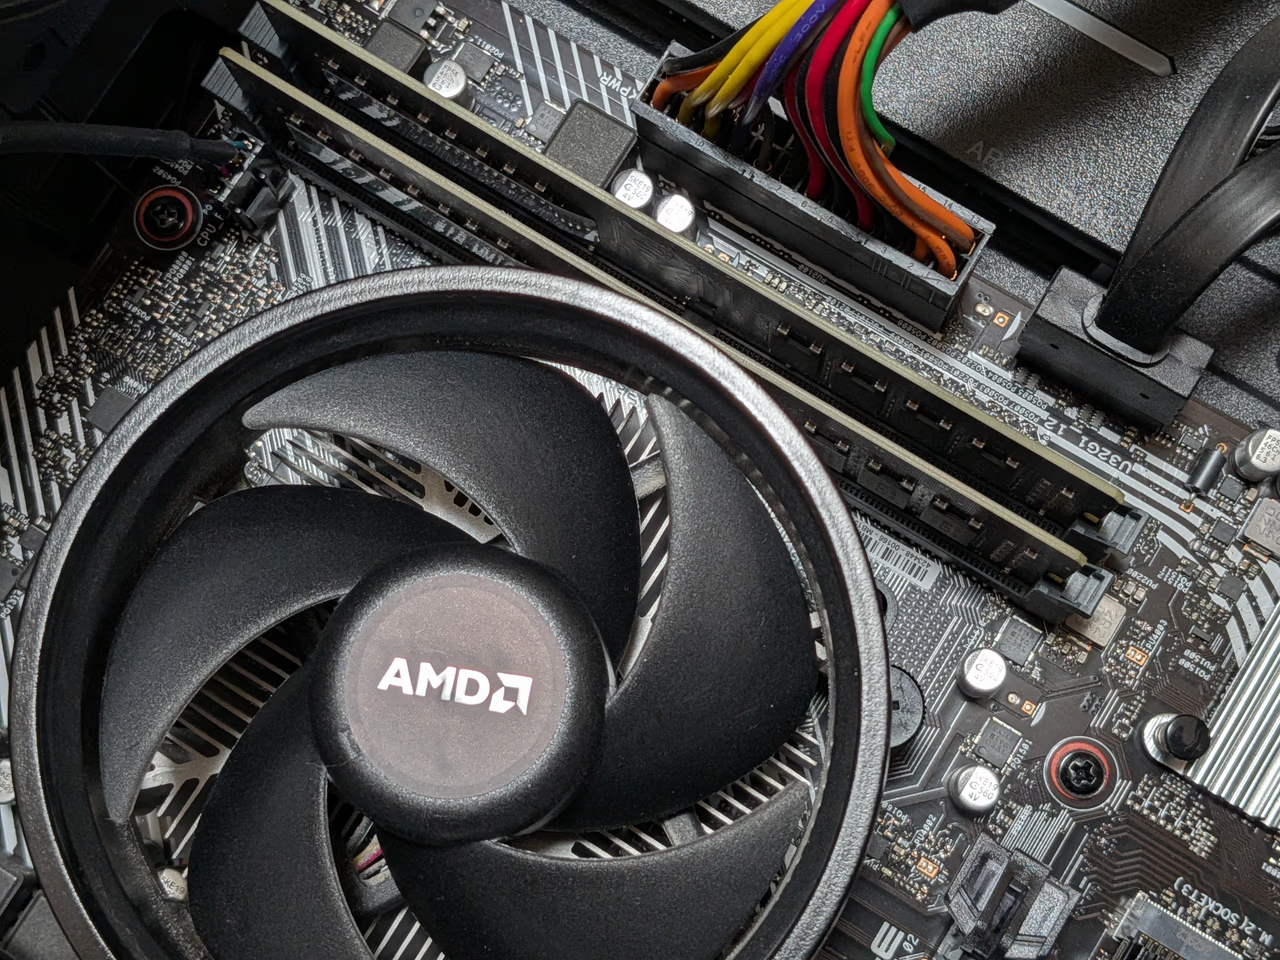
PCは以前の記事で作成した構成のままです。
小型ケースにAMD Radeon PRO W6800を搭載し、16GB×2枚のメモリで合計32GB構成になっています。
ASUS PRIME A520M-EにはDIMMスロットが2本しかないため、既存の16GB×2枚を取り外して32GB×2枚に交換する必要があります。
交換後
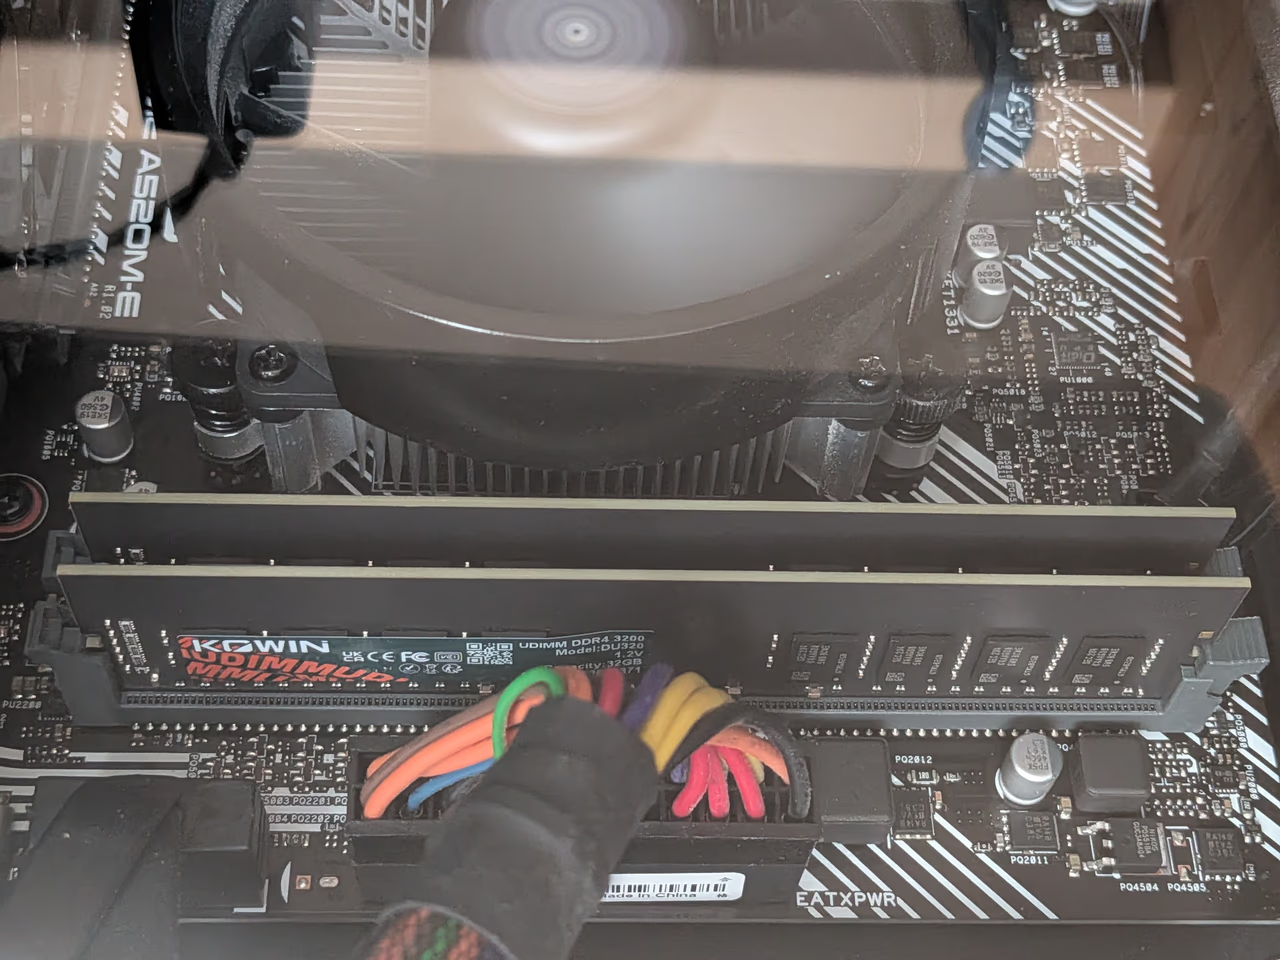
新しいKOWIN DU3200 UDIMM 64GB(32GB×2) DDR4-3200を取り付けた後の様子です。
再起動後、特に問題なく64GB構成として認識されました。
Strataの導入
Strataとは
Strataは、モデルデータをVRAM・メインメモリ・NVMeに分散配置して大容量モデルを動かすローカルLLM実行環境です。
OpenAI/AnthropicスタイルのAPIを持っており、ローカルで稼働させたモデルを各ツールから呼び出せます。
導入手順
公式サイトのREADMEに従って、ターミナルアプリ版を導入しました。
Radeon PRO W6800は、RDNA2(gfx1030)に該当するGPUです。
2026/11時点では、対応ハードウェアの一覧にexperimental(試験的)として掲載されています。含まれるパッケージ情報を確認する限り、Linux版の方が動作実績があるようです。
今後、Windows版でも安定して動作するようになることを期待しています。
パフォーマンス
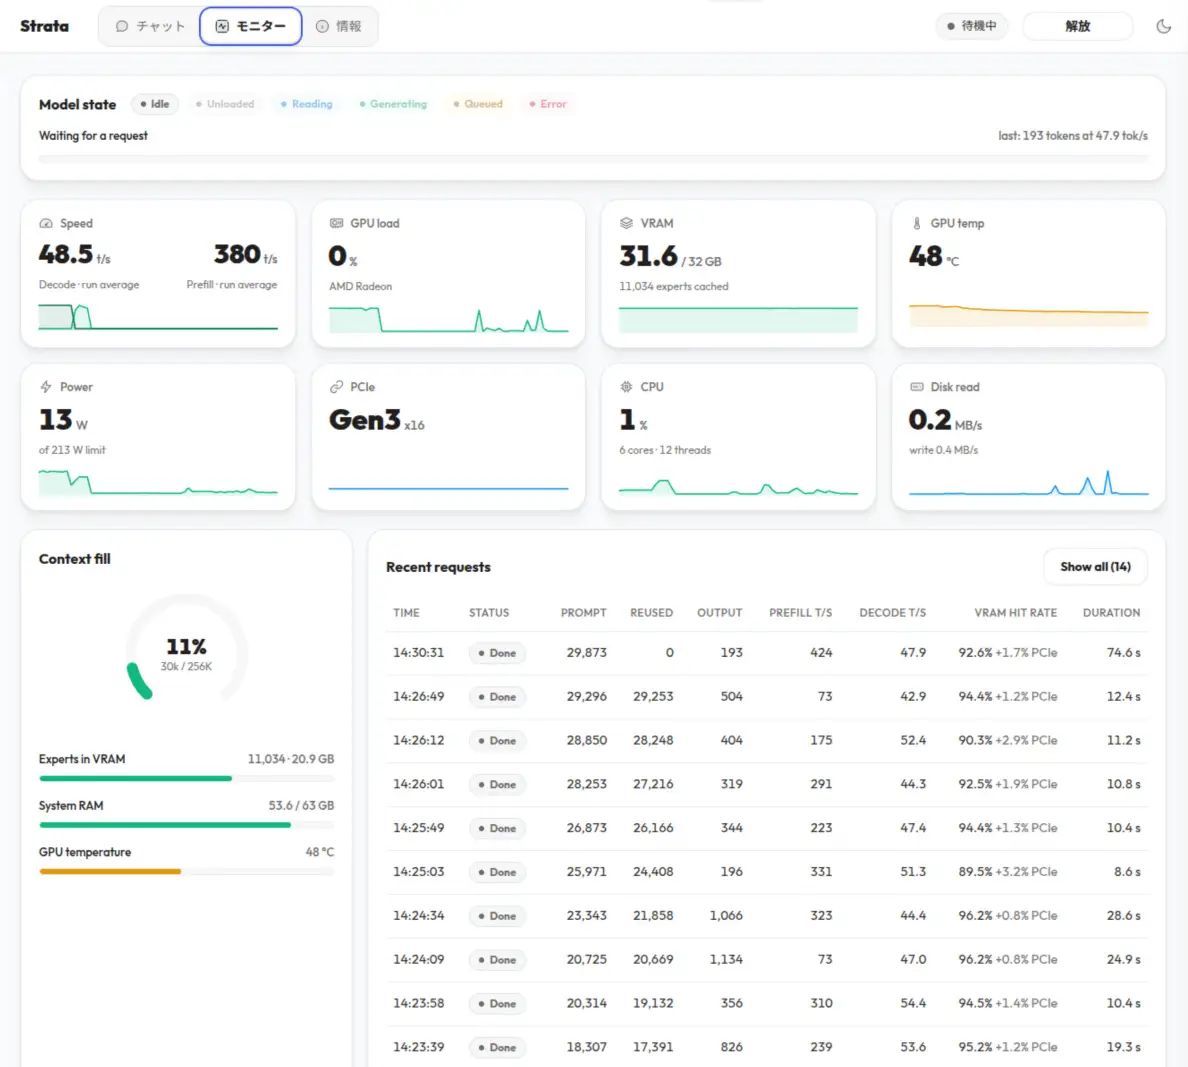
Strataで Qwen3.8-Flash-Next IQ3_Sを稼働させ、パフォーマンスを測定しました。
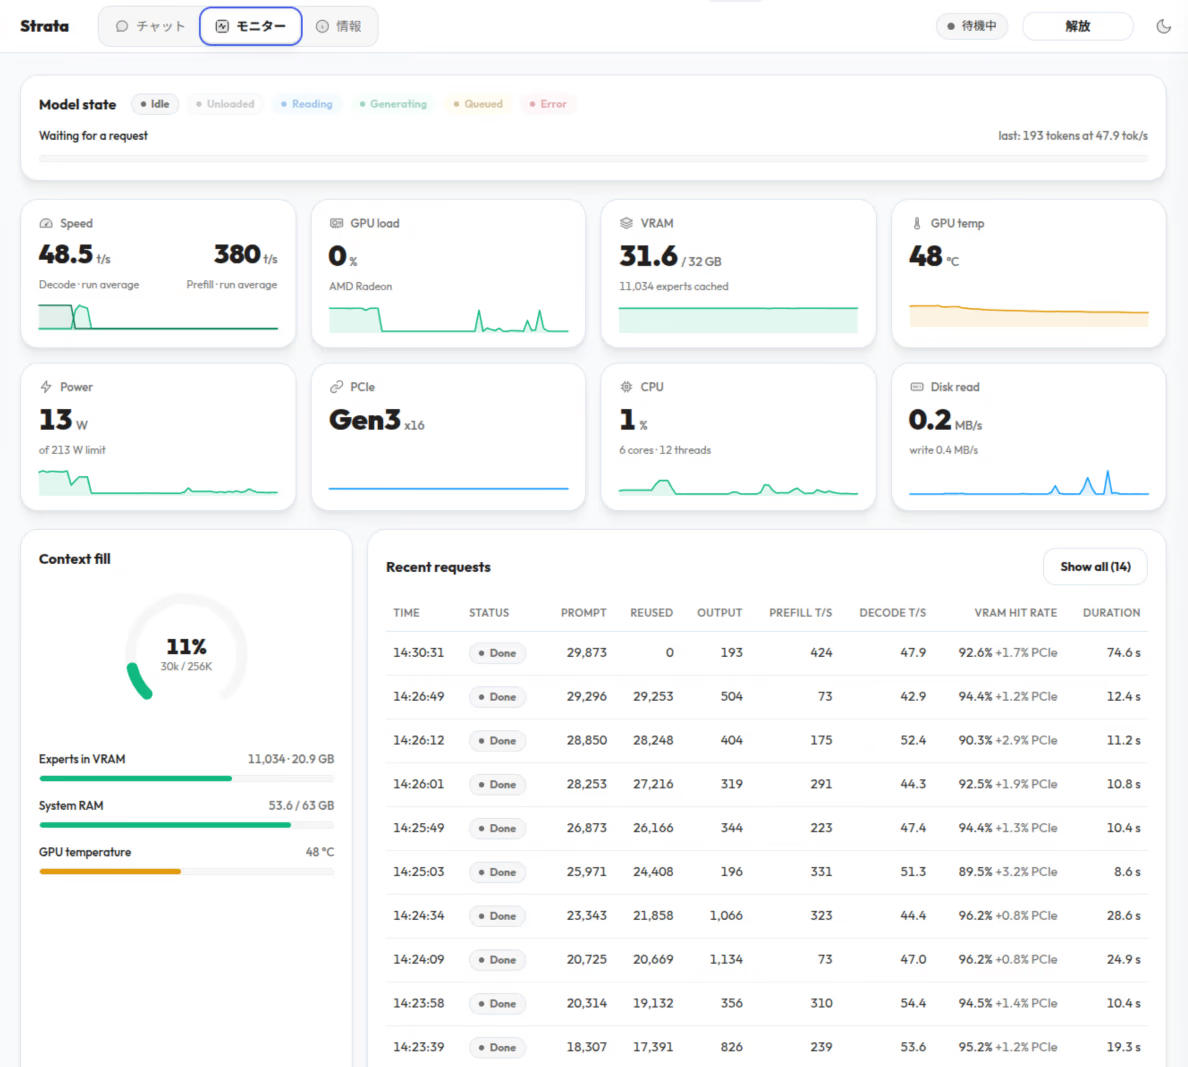
Decodeは48.5 tok/s、Prefillは380 tok/sを記録しました。コンテキストの長さやモデルの種類によって速度は変動しますが、十分な速度で動作しています。
他の導入事例と比べてPrefillの速度が遅い気がしますが、Radeon PRO W6800に比べてCPUやマザーボードのスペックが低いことが影響しているかもしれません。
| 項目 | 値 |
|---|---|
| Decode | 48.5 tok/s |
| Prefill | 380 tok/s |
| VRAM | 31.6GB/32GB |
| Experts in VRAM | 11034個・20.9GB |
| System RAM | 53.6GB/63GB |
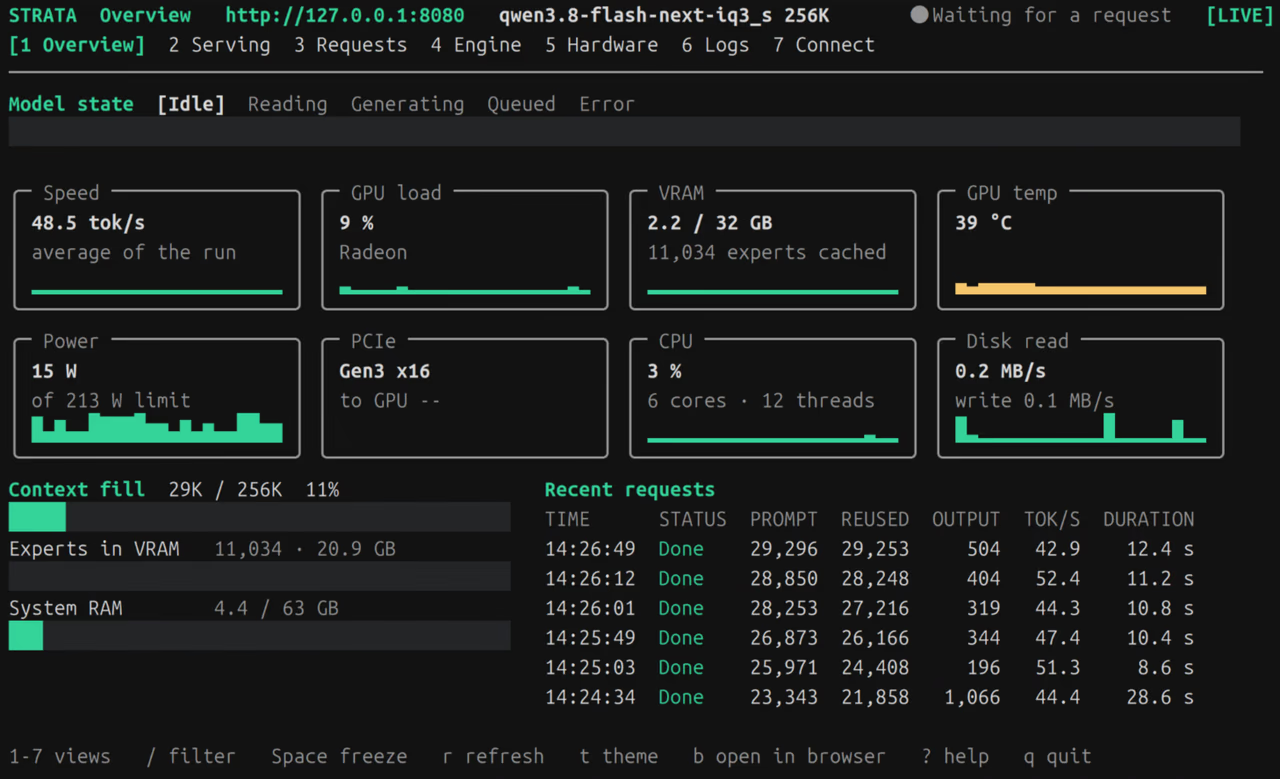
ターミナル上でも、リクエストごとのPrefill・Decode速度と直近のリクエスト履歴をリアルタイムに確認できます。
まとめ
ローカルLLM実行環境Strataはメインメモリ64GB以上が推奨されるため、16GB×2枚の合計32GBだったPCにKOWIN DU3200 UDIMM 64GB(32GB×2) DDR4-3200を装着し、モジュール交換で64GB構成へ切り替えました。
Qwen3.8-Flash-Next IQ3_S を自宅で利用できるようになり、ローカルでのLLM実行環境がさらに充実しました。利用している機材の組み合わせによって、パフォーマンス改善の余地がありそうなので、今後も試行錯誤していきたいと思います。

